¿Qué es la significancia estadística?
Definición fundamental
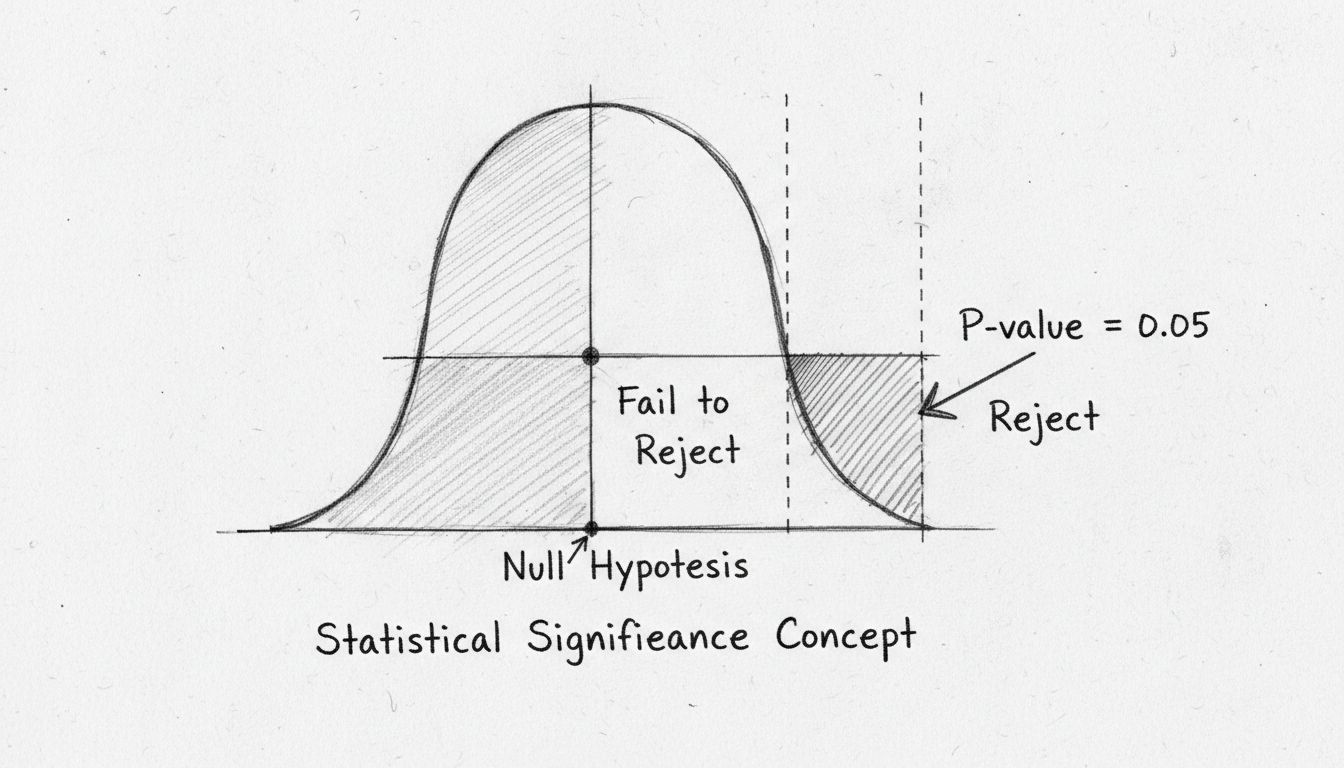
La significancia estadística es la probabilidad de que una relación entre dos o más variables sea causada por algo distinto al azar. En términos formales, es la probabilidad de que una diferencia observada —o una más extrema— ocurriría si la hipótesis nula (la suposición de que no hay efecto real) fuera verdadera.
Significancia estadística vs. azar
Todo conjunto de datos contiene variación aleatoria —la fluctuación natural que ocurre incluso cuando no existe un efecto subyacente. Lance una moneda justa 100 veces y rara vez obtendrá exactamente 50 caras. Esa desviación es ruido aleatorio, no evidencia de que la moneda esté sesgada.
La significancia estadística cuantifica si la desviación que observa es lo suficientemente grande, en relación con el tamaño de su muestra, como para ser improbable solo bajo el ruido aleatorio. Cuando lo es, puede rechazar la hipótesis nula y concluir que probablemente existe un efecto real.
Dos conceptos relacionados ayudan aquí:
- Azar: La probabilidad de que una diferencia observada surja puramente de la variabilidad del muestreo.
- Variación aleatoria (o ruido aleatorio): La imprevisibilidad inherente en cualquier proceso de medición. Las muestras más grandes reducen su influencia, facilitando la detección de efectos reales.
Un ejemplo sencillo del mundo real
Suponga que administra una tienda en línea y prueba dos versiones de una página de producto. La versión A convierte al 4.2%. La versión B convierte al 4.8%. Esa es una diferencia de 0.6 puntos porcentuales —pero ¿es real?
Si el valor p fuera 0.30, sin embargo, la misma brecha sería completamente consistente con el azar —y actuar sobre ella sería prematuro.
Lanza tu programa de afiliados hoy
Configura el seguimiento avanzado en minutos. No se requiere tarjeta de crédito.
Cómo funciona la significancia estadística
La hipótesis nula y la hipótesis alternativa
Toda prueba de significancia comienza con dos afirmaciones contrapuestas:
- Hipótesis nula (H₀): No hay diferencia o relación real. Cualquier diferencia observada se debe a la variación aleatoria.
- Hipótesis alternativa (H₁): Existe una diferencia o relación real.
Comprendiendo los valores P
Interpretaciones erróneas comunes que debe evitar:
- p = 0.03 NO significa que haya un 3% de probabilidad de que la hipótesis nula sea verdadera. Describe la probabilidad de los datos bajo la hipótesis nula, no la probabilidad de la hipótesis nula dados los datos.
- p = 0.03 NO significa que el efecto tenga un 97% de probabilidad de ser real. El valor p no dice nada sobre la probabilidad de que la hipótesis alternativa sea correcta.
- Un valor p superior a 0.05 NO prueba la hipótesis nula. Significa que los datos no son lo suficientemente sorprendentes como para rechazarla —lo cual es una afirmación completamente diferente.
Niveles de significancia (Alfa)
El nivel de significancia, denotado como α (alfa), es el umbral que establece antes de ejecutar una prueba. Representa su tolerancia a los falsos positivos —rechazar la hipótesis nula cuando en realidad es verdadera. Esto también se llama error Tipo I.
| Umbral | Significado | Riesgo de falso positivo |
|---|
| α = 0.05 | Estándar en la mayoría de los campos | 5% (1 de cada 20) |
| α = 0.01 | Más estricto; se usa cuando los falsos positivos son costosos | 1% (1 de cada 100) |
| α = 0.001 | Muy estricto; decisiones de alto riesgo | 0.1% (1 de cada 1,000) |
Si p < α, el resultado es estadísticamente significativo en ese nivel.
Intervalos de confianza explicados
Un intervalo de confianza proporciona un rango de valores plausibles para el tamaño del efecto real. Un intervalo de confianza del 95% significa: si repitiera el estudio 100 veces, aproximadamente 95 de esos intervalos contendrían el valor real.
Los intervalos más estrechos indican estimaciones más precisas —generalmente resultado de tamaños de muestra más grandes. En contextos empresariales, los intervalos de confianza suelen ser más informativos que los valores p por sí solos porque muestran la magnitud y dirección de un efecto, no solo si existe.
¿Es 0.05 estadísticamente significativo? (y otros umbrales)
La convención del 0.05
Sí —en la mayoría de los campos aplicados, p < 0.05 es el estándar para reclamar significancia estadística. Esta convención se remonta al trabajo de Ronald Fisher en la década de 1920 y, aunque algo arbitraria, ha persistido porque equilibra dos riesgos: los falsos positivos (errores Tipo I) y los falsos negativos (errores Tipo II, donde se pasa por alto un efecto real).
0.01 vs. 0.05: ¿Cuál es más significativo?
Un valor p de 0.01 es más estadísticamente significativo que 0.05 porque indica una menor probabilidad de que el resultado observado se deba al azar. Con α = 0.01, acepta solo un 1% de riesgo de falso positivo, en comparación con el 5% con α = 0.05.
Sin embargo, un valor p más bajo no significa automáticamente un efecto mayor o más importante. Con una muestra masiva, incluso una diferencia trivialmente pequeña puede producir p < 0.001. Por eso el tamaño del efecto y la significancia práctica deben evaluarse junto con el valor p.
Únete a nuestro boletín
Sé el primero en conocer las nuevas funciones y actualizaciones del producto.
Factores que afectan la significancia estadística
Tamaño de la muestra
El tamaño de la muestra es el factor más influyente. Las muestras más grandes reducen el impacto de la variación aleatoria, facilitando la detección de diferencias reales. Por eso un aumento del 2% en la conversión podría ser significativo con 50,000 visitantes pero no con 500.
Tamaño del efecto
El tamaño del efecto mide la magnitud de la diferencia observada —no solo si existe. Un tamaño de efecto grande (por ejemplo, un aumento del 30% en la conversión) alcanza la significancia más rápido y con muestras más pequeñas. Un tamaño de efecto pequeño (por ejemplo, 0.5%) requiere muestras enormes para detectarse de manera confiable.
Aquí es donde la relación entre la significancia estadística y la significancia práctica se vuelve crítica. Un hallazgo puede ser estadísticamente significativo pero prácticamente irrelevante si el efecto es demasiado pequeño para importar en las decisiones empresariales.
Calidad de los datos
Ninguna prueba estadística puede compensar los datos deficientes. Los problemas comunes de calidad de datos incluyen:
- Sesgo de selección: La muestra no representa a la población objetivo.
- Error de medición: La métrica que se rastrea no es confiable o es inconsistente.
- Variables de confusión: Un factor no medido está impulsando la diferencia observada.
Antes de calcular la significancia estadística, verifique que su recopilación de datos sea limpia, consistente y esté libre de sesgos sistemáticos. Un resultado significativo a partir de datos defectuosos es peor que ningún resultado.
Potencia estadística
La potencia depende del tamaño de la muestra, el tamaño del efecto y el nivel de significancia elegido. Los estudios con poca potencia son una razón común por la que los resultados aparentemente prometedores de pruebas A/B no logran replicarse.
Definición fundamental
La significancia estadística es la probabilidad de que una relación entre dos o más variables sea causada por algo distinto al azar. En términos formales, es la probabilidad de que una diferencia observada —o una más extrema— ocurriría si la hipótesis nula (la suposición de que no hay efecto real) fuera verdadera.
El marco proviene de la prueba de hipótesis, una rama del análisis estadístico desarrollada a principios del siglo XX por Ronald Fisher y refinada por Jerzy Neyman y Egon Pearson.
Significancia estadística vs. azar
Todo conjunto de datos contiene variación aleatoria —la fluctuación natural que ocurre incluso cuando no existe un efecto subyacente. Lance una moneda justa 100 veces y rara vez obtendrá exactamente 50 caras. Esa desviación es ruido aleatorio, no evidencia de que la moneda esté sesgada.
La significancia estadística cuantifica si la desviación que observa es lo suficientemente grande, en relación con el tamaño de su muestra, como para ser improbable solo bajo el ruido aleatorio. Cuando lo es, puede rechazar la hipótesis nula y concluir que probablemente existe un efecto real.
Dos conceptos relacionados ayudan aquí:
- Azar: La probabilidad de que una diferencia observada surja puramente de la variabilidad del muestreo.
- Variación aleatoria (o ruido aleatorio): La imprevisibilidad inherente en cualquier proceso de medición. Las muestras más grandes reducen su influencia, facilitando la detección de efectos reales.
Un ejemplo sencillo del mundo real
Suponga que administra una tienda en línea y prueba dos versiones de una página de producto. La versión A convierte al 4.2%. La versión B convierte al 4.8%. Esa es una diferencia de 0.6 puntos porcentuales —pero ¿es real?
Realiza una prueba estadística. Devuelve un valor p de 0.03.
Si el valor p fuera 0.30, sin embargo, la misma brecha sería completamente consistente con el azar —y actuar sobre ella sería prematuro.
La hipótesis nula y la hipótesis alternativa
Toda prueba de significancia comienza con dos afirmaciones contrapuestas:
- Hipótesis nula (H₀): No hay diferencia o relación real. Cualquier diferencia observada se debe a la variación aleatoria.
- Hipótesis alternativa (H₁): Existe una diferencia o relación real.
La prueba no demuestra H₁ directamente.
Este marco se aplica directamente a las pruebas A/B.
Comprendiendo los valores P
Interpretaciones erróneas comunes que debe evitar:
- p = 0.03 NO significa que haya un 3% de probabilidad de que la hipótesis nula sea verdadera. Describe la probabilidad de los datos bajo la hipótesis nula, no la probabilidad de la hipótesis nula dados los datos.
- p = 0.03 NO significa que el efecto tenga un 97% de probabilidad de ser real. El valor p no dice nada sobre la probabilidad de que la hipótesis alternativa sea correcta.
- Un valor p superior a 0.05 NO prueba la hipótesis nula. Significa que los datos no son lo suficientemente sorprendentes como para rechazarla —lo cual es una afirmación completamente diferente.
Niveles de significancia (Alfa)
El nivel de significancia, denotado como α (alfa), es el umbral que establece antes de ejecutar una prueba. Representa su tolerancia a los falsos positivos —rechazar la hipótesis nula cuando en realidad es verdadera. Esto también se llama error Tipo I.
| Umbral | Significado | Riesgo de falso positivo |
|---|
| α = 0.05 | Estándar en la mayoría de los campos | — |
| α = 0.01 | Más estricto; se usa cuando los falsos positivos son costosos | — |
| α = 0.001 | Muy estricto; decisiones de alto riesgo | — |
Si p < α, el resultado es estadísticamente significativo en ese nivel.
Intervalos de confianza explicados
Un intervalo de confianza proporciona un rango de valores plausibles para el tamaño del efecto real. Un intervalo de confianza del 95% significa: si repitiera el estudio 100 veces, aproximadamente 95 de esos intervalos contendrían el valor real.
Los intervalos más estrechos indican estimaciones más precisas —generalmente resultado de tamaños de muestra más grandes. En contextos empresariales, los intervalos de confianza suelen ser más informativos que los valores p por sí solos porque muestran la magnitud y dirección de un efecto, no solo si existe.
La convención del 0.05
Sí —en la mayoría de los campos aplicados, p < 0.05 es el estándar para reclamar significancia estadística. Esta convención se remonta al trabajo de Ronald Fisher en la década de 1920 y, aunque algo arbitraria, ha persistido porque equilibra dos riesgos: los falsos positivos (errores Tipo I) y los falsos negativos (errores Tipo II, donde se pasa por alto un efecto real).
0.01 vs. 0.05: ¿Cuál es más significativo?
Un valor p de 0.01 es más estadísticamente significativo que 0.05 porque indica una menor probabilidad de que el resultado observado se deba al azar. Con α = 0.01, acepta solo un 1% de riesgo de falso positivo, en comparación con el 5% con α = 0.05.
Sin embargo, un valor p más bajo no significa automáticamente un efecto mayor o más importante. Con una muestra masiva, incluso una diferencia trivialmente pequeña puede producir p < 0.001. Por eso el tamaño del efecto y la significancia práctica deben evaluarse junto con el valor p.
Cuando p < 0.001
Un valor p por debajo de 0.001 significa que el resultado observado ocurriría por azar menos de 1 vez en 1,000 si la hipótesis nula fuera verdadera. Esta es una evidencia sólida contra la hipótesis nula —pero aún no garantiza importancia práctica.
Tamaño de la muestra
El tamaño de la muestra es el factor más influyente. Las muestras más grandes reducen el impacto de la variación aleatoria, facilitando la detección de diferencias reales. Por eso un aumento del 2% en la conversión podría ser significativo con 50,000 visitantes pero no con 500.
Para sitios con poco tráfico, esto significa que las pruebas deben ejecutarse durante más tiempo o apuntar a cambios de efecto más grandes.
Tamaño del efecto
El tamaño del efecto mide la magnitud de la diferencia observada —no solo si existe. Un tamaño de efecto grande (por ejemplo, un aumento del 30% en la conversión) alcanza la significancia más rápido y con muestras más pequeñas. Un tamaño de efecto pequeño (por ejemplo, 0.5%) requiere muestras enormes para detectarse de manera confiable.
Aquí es donde la relación entre la significancia estadística y la significancia práctica se vuelve crítica. Un hallazgo puede ser estadísticamente significativo pero prácticamente irrelevante si el efecto es demasiado pequeño para importar en las decisiones empresariales.
Calidad de los datos
Ninguna prueba estadística puede compensar los datos deficientes. Los problemas comunes de calidad de datos incluyen:
- Sesgo de selección: La muestra no representa a la población objetivo.
- Error de medición: La métrica que se rastrea no es confiable o es inconsistente.
- Variables de confusión: Un factor no medido está impulsando la diferencia observada.
Antes de calcular la significancia estadística, verifique que su recopilación de datos sea limpia, consistente y esté libre de sesgos sistemáticos. Un resultado significativo a partir de datos defectuosos es peor que ningún resultado.
Potencia estadística
La potencia estadística es la probabilidad de que una prueba detecte un efecto real cuando existe. Es el complemento de la tasa de error Tipo II (β).
La potencia depende del tamaño de la muestra, el tamaño del efecto y el nivel de significancia elegido. Los estudios con poca potencia son una razón común por la que los resultados aparentemente prometedores de pruebas A/B no logran replicarse.
Cómo calcular la significancia estadística
Pruebas estadísticas comunes
Los diferentes tipos de datos requieren diferentes pruebas:
| Prueba | Caso de uso | Ejemplo |
|---|
| Prueba T | Comparación de medias de dos grupos | Tasas de conversión: Versión A vs. Versión B |
| Prueba de chi-cuadrado | Comparación de frecuencias categóricas | Tasas de clics en múltiples creatividades publicitarias |
| Prueba Z | Comparación de proporciones con muestras grandes | Proporciones de conversión de páginas de aterrizaje |
| ANOVA | Comparación de medias entre tres o más grupos | Rendimiento entre múltiples socios afiliados |
Uso de calculadoras y herramientas en línea
No necesita calcular la significancia estadística manualmente. Las herramientas más utilizadas incluyen:
- Plataformas de pruebas A/B (Optimizely, VWO, Google Optimize) — cálculos de significancia integrados
- Calculadoras independientes (herramientas de Evan Miller, AB Testguide) — gratuitas, basadas en web
- Software estadístico (R, SciPy de Python, SPSS) — para análisis personalizados
La mayoría de las herramientas informan tanto el valor p como el intervalo de confianza. Verifique siempre ambos antes de tomar una decisión.
Flujo de trabajo paso a paso para pruebas A/B
- Defina su métrica: Elija una única métrica principal (tasa de conversión, tasa de clics, ingresos por visitante).
- Calcule el tamaño de muestra requerido: Use una calculadora de tamaño de muestra basada en su tasa de conversión base y el efecto mínimo detectable.
- Aleatorice y ejecute la prueba: Divida el tráfico equitativamente entre control y tratamiento. No detenga la prueba temprano.
- Analice los resultados: Compare el valor p con α. Examine el intervalo de confianza para el tamaño del efecto.
- Decida: Si es significativo y prácticamente relevante, implemente la variación ganadora. Si no, documente el hallazgo y pruebe otra cosa.
Significancia estadística en el marketing de afiliados
La significancia estadística no es solo un concepto académico. En el marketing de afiliados, donde las comisiones, los presupuestos y las relaciones con los socios dependen de los datos de rendimiento, es una salvaguarda práctica contra costosos errores de juicio.
Para anunciantes
Los anunciantes que gestionan programas de afiliados prueban rutinariamente páginas de aterrizaje, estructuras de ofertas y activos creativos. La significancia estadística garantiza que las decisiones sobre qué versión escalar se basen en diferencias de rendimiento reales, no en fluctuaciones aleatorias.
Ejemplo de flujo de trabajo: Un anunciante prueba dos estructuras de comisión —una tasa fija del 10% frente a un modelo escalonado del 5%/12%/18%. Después de 30 días y 5,000 transacciones, el modelo escalonado muestra un valor promedio de pedido un 22% más alto. Una prueba T arroja p = 0.02. El anunciante puede implementar con confianza la estructura escalonada, sabiendo que la diferencia observada probablemente no sea ruido aleatorio.
Sin una prueba de significancia, el anunciante podría haber hecho el cambio basándose en una fluctuación a corto plazo —y potencialmente haber reducido las ganancias de los socios si el efecto se revertía.
Para editores
Los editores (afiliados) toman decisiones sobre qué productos promocionar, en qué fuentes de tráfico invertir y qué formatos de contenido convierten mejor. Cada una de estas decisiones se beneficia de las pruebas de significancia.
Ejemplo de flujo de trabajo: Un editor ejecuta dos versiones de un artículo de reseña —una con una tabla comparativa al principio y otra con la tabla al final. En 10,000 visitas a la página, la versión con la tabla al principio genera una tasa de clics del 3.1% hacia el comerciante frente al 2.6% de la versión con la tabla al final. Una prueba de chi-cuadrado arroja p = 0.04. El editor adopta el formato con la tabla al principio y aplica el patrón a otras reseñas.
Para gestores de programas de afiliados
Los gestores de programas evalúan el rendimiento de los socios, establecen niveles de comisión y deciden qué afiliados reclutar o retener. La significancia estadística ayuda a distinguir entre los que tienen un rendimiento consistentemente alto y aquellos cuyos buenos meses son solo variación.
Ejemplo de flujo de trabajo: Un gestor de programas compara dos afiliados con volúmenes de tráfico similares. El afiliado A tiene una tasa de conversión del 5.2% durante 12 meses; el afiliado B tiene un 4.1%. Una prueba Z de dos muestras confirma que la diferencia es significativa (p = 0.008). El gestor utiliza estos datos para asignar comisiones de nivel superior al afiliado A e investigar qué podría mejorar el afiliado B.
En los tres roles, el principio es el mismo: deje que los datos alcancen la significancia antes de actuar. Las decisiones prematuras —aumentar las comisiones para un socio que tuvo un buen mes, o abandonar una página de aterrizaje que tuvo una mala semana— se encuentran entre los errores más comunes y evitables en el marketing de afiliados.
Limitaciones y conceptos erróneos comunes
Significativo ≠ Importante
Este es el malentendido más persistente. Un resultado puede ser estadísticamente significativo con p < 0.001 y aún así ser demasiado pequeño para importar. En un ejemplo muy conocido del manual de estadística de ingeniería del NIST, una mejora en un proceso de fabricación fue estadísticamente significativa pero produjo una ganancia de solo 0.2 unidades —muy por debajo del umbral de valor práctico.
Hágase siempre dos preguntas:
- ¿Es estadísticamente significativo? (el valor p)
- ¿Es el efecto lo suficientemente grande como para importar? (el tamaño del efecto)
Manipulación de valores p y la crisis de reproducibilidad
La manipulación de valores p (p-hacking) se refiere a la práctica de ejecutar múltiples análisis y reportar selectivamente solo aquellos que alcanzan significancia. Las formas comunes incluyen:
- Probar muchas métricas y destacar la que «gana»
- Detener la recopilación de datos cuando p cruza 0.05
- Excluir valores atípicos a posteriori para reducir el valor p
Estas prácticas inflan drásticamente las tasas de falsos positivos.
La lección para los usuarios empresariales: registre previamente su plan de prueba, limítese a una métrica principal y resista la tentación de buscar significancia.
Cuándo no confiar en la significancia estadística
La significancia estadística es menos útil —o directamente engañosa— en estos escenarios:
- Muestras muy pequeñas: Con menos de 100 observaciones por grupo, solo efectos enormes alcanzarán la significancia. Los resultados negativos no son informativos, no son evidencia de ausencia de efecto.
- Múltiples cambios simultáneos: Si cambia cinco elementos de una página a la vez, un resultado significativo no puede indicarle qué cambio generó el efecto.
- Trabajo exploratorio de bajo riesgo: No todas las decisiones requieren una prueba de significancia formal. Para la exploración en etapas tempranas, los datos direccionales pueden ser suficientes.