

¿Cómo funcionan los rastreadores web? Guía técnica completa
Aprende cómo funcionan los rastreadores web, desde las URLs semilla hasta la indexación. Comprende el proceso técnico, los tipos de rastreadores, las reglas de ...
11 min de lectura
Un rastreador de motores de búsqueda es un programa de software automatizado —también llamado bot, araña o spiderbot— que navega sistemáticamente por la World Wide Web, descarga el contenido de las páginas y sigue hipervínculos para descubrir URL nuevas o actualizadas.
Un rastreador de motores de búsqueda es un programa de software automatizado —también llamado bot, araña o spiderbot— que navega sistemáticamente por la World Wide Web, descarga el contenido de las páginas y sigue hipervínculos para descubrir URL nuevas o actualizadas. Su función principal es alimentar el índice de un motor de búsqueda con datos frescos para que, cuando alguien realiza una consulta, el motor pueda devolver resultados relevantes y actualizados. Sin los rastreadores, un motor de búsqueda no tiene forma de saber que una página existe.
El rastreador en sí mismo no clasifica nada. Descubre y entrega lo que encuentra —texto, enlaces, metadatos, imágenes— a un sistema separado de indexación y clasificación. El rastreo, la indexación y la clasificación son tres etapas distintas. Una página puede ser rastreada y aun así nunca aparecer en los resultados de búsqueda si no cumple con los umbrales de calidad del motor durante la indexación.
La documentación de rastreadores de Google distingue entre sus rastreadores comunes, rastreadores de casos especiales y buscadores activados por el usuario. Consulta la identidad y el comportamiento documentados del rastreador correspondiente al investigar problemas de acceso.
En esta página
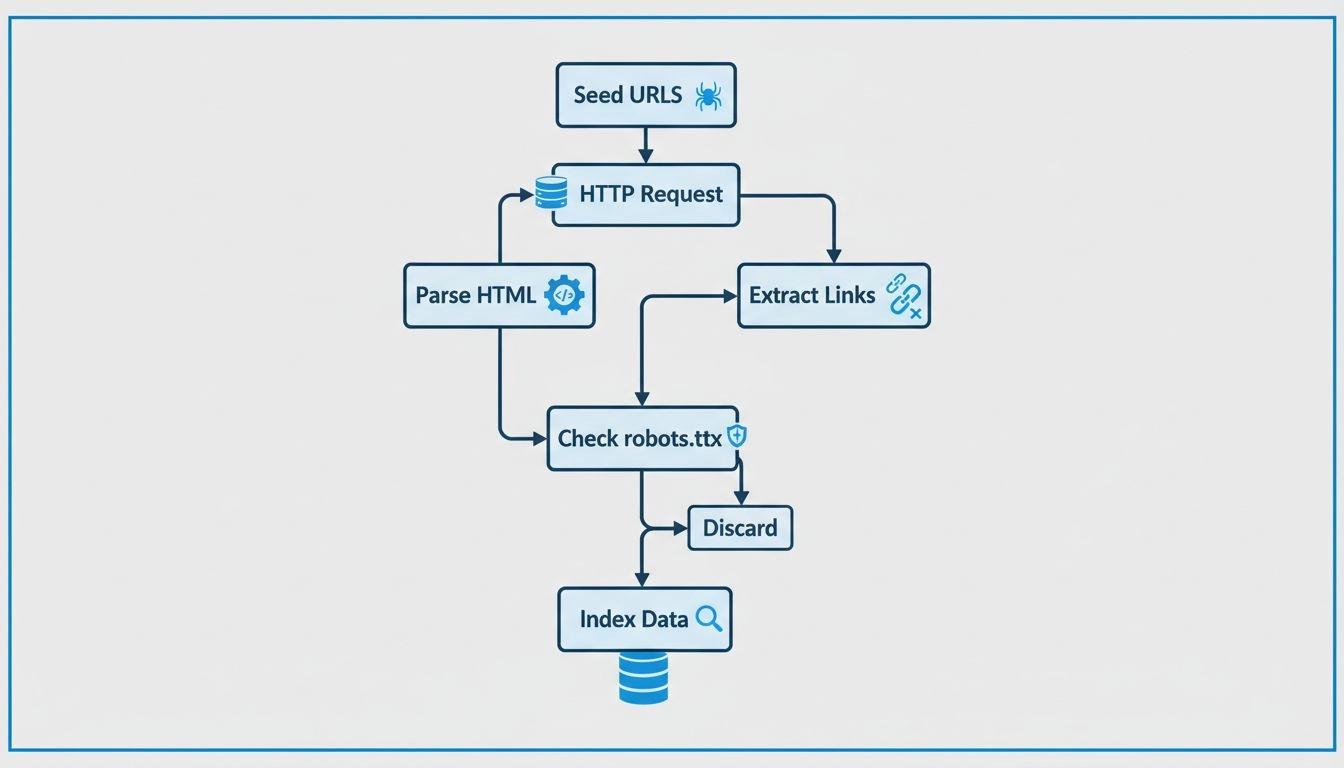
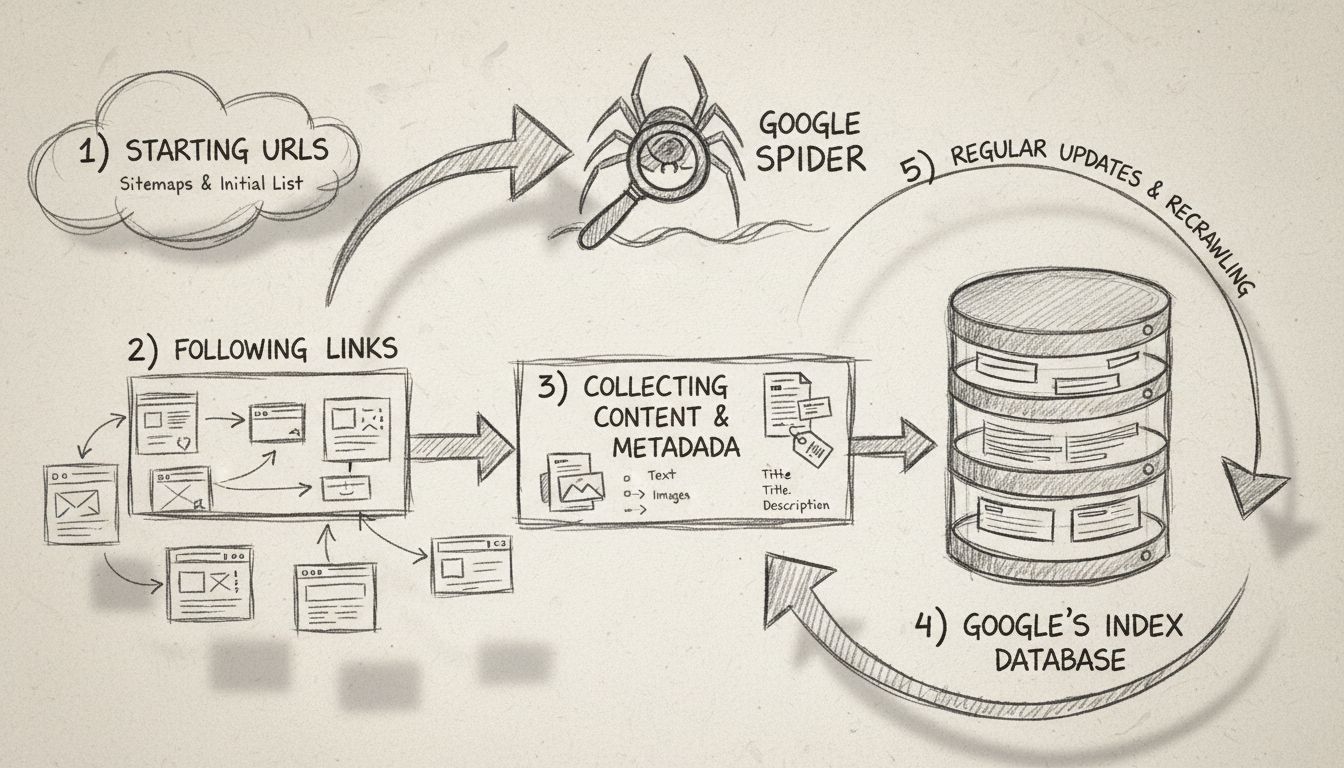
Un rastreador web opera en un bucle continuo basado en unos pocos pasos fundamentales. Comprender estos pasos ayuda a los propietarios de sitios web a diagnosticar por qué las páginas pueden no aparecer en los resultados de búsqueda —el problema suele estar en la etapa de rastreo, mucho antes de que siquiera se considere la clasificación.
Cada rastreador comienza con un conjunto de URL conocidas llamadas URL semilla. Estas pueden provenir de páginas previamente rastreadas, sitemaps enviados o puntos de partida seleccionados manualmente. El rastreador descarga cada página semilla, extrae todos los hipervínculos que encuentra y agrega cualquier enlace que no haya visto antes a una cola de ejecución llamada la frontera de rastreo.
El ciclo luego se repite:
Este bucle nunca termina realmente. La web cambia constantemente y aparecen nuevas páginas cada segundo, por lo que un rastreador simplemente trabaja con lo que sigue en la cola, revisitando páginas antiguas para verificar cambios y agregando URL recién descubiertas.
Una vez que un rastreador obtiene una página, renderiza el contenido —leyendo el HTML, ejecutando JavaScript cuando es posible y extrayendo el texto, las imágenes, los metadatos y los datos estructurados. Luego descarga esta información y la pasa al indexador del motor de búsqueda.
No todos los rastreadores manejan JavaScript por igual. Googlebot renderiza JavaScript y espera el contenido cargado dinámicamente, pero los rastreadores de motores de búsqueda más pequeños solo pueden leer HTML estático. Por esto, los sitios construidos enteramente con frameworks de JavaScript del lado del cliente pueden ser invisibles para algunos motores de búsqueda a menos que se implemente renderizado del lado del servidor.
Los rastreadores descubren nuevas páginas a través de dos canales principales:

Configura el seguimiento avanzado en minutos. No se requiere tarjeta de crédito.
Los rastreadores no tratan todas las páginas por igual. Operan bajo un conjunto de políticas de rastreo que determinan qué páginas visitar, en qué orden y con qué frecuencia regresar.
Un rastreador debe decidir qué URL priorizar desde su frontera de rastreo. Las señales comunes incluyen:
La frecuencia con la que un rastreador regresa a una página depende de qué tan frecuentemente cambia esa página. La página principal de un sitio de noticias puede rastrearse cada pocos minutos. Una página estática “Acerca de nosotros” puede revisitarse una vez cada varios meses. Los webmasters pueden indicar la frecuencia de cambio mediante etiquetas <changefreq> en el sitemap XML, aunque los motores de búsqueda tratan estas como sugerencias, no como órdenes.
Los rastreadores están programados para evitar sobrecargar los servidores web. Respetan un límite de velocidad de rastreo —el número máximo de solicitudes que enviarán a un solo sitio en un período determinado. Si un servidor responde con errores HTTP como 500 o 503, el rastreador retrocede para no empeorar el problema. Esto es parte de lo que hace que el rastreo a escala sea un verdadero desafío de ingeniería.
El archivo robots.txt es un documento de texto plano ubicado en la raíz de un dominio que indica a los rastreadores qué URL pueden y no pueden solicitar. Es la herramienta más importante para gestionar el acceso de los rastreadores. Una entrada de robots.txt podría verse así:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ pero permita todo en /public/. Otros rastreadores verifican el mismo archivo y siguen sus propias directivas User-agent. Vale la pena señalar que robots.txt es un protocolo voluntario —los rastreadores bien comportados lo obedecen, pero los bots maliciosos pueden ignorarlo por completo.El presupuesto de rastreo es la cantidad de páginas que un motor de búsqueda rastreará en un sitio dentro de un período determinado. Está determinado por dos factores:
Para sitios pequeños, el presupuesto de rastreo rara vez es una preocupación. Para grandes plataformas de comercio electrónico o sitios de contenido con millones de URL, gestionar el presupuesto de rastreo se vuelve esencial —los rastreos desperdiciados en contenido duplicado, parámetros de navegación facetada o páginas de bajo valor significan menos recursos para las páginas que importan.
Cada motor de búsqueda importante opera su propio rastreador con una cadena de user-agent distintiva —un identificador que el bot envía con cada solicitud HTTP para que los servidores sepan qué rastreador está visitando.
| Motor de búsqueda | Nombre del rastreador | Identificador User-Agent | Propósito |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Rastrea e indexa páginas web para Google Search y otros servicios de Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Rastrea e indexa páginas para Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Rastrea páginas para los resultados de búsqueda de DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Rastrea páginas para Yandex Search (dominante en Rusia) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Rastrea páginas para Baidu Search (dominante en China) |
| Apple | Applebot | Applebot/1.0 | Rastrea páginas para Spotlight Search y sugerencias de Siri |
Google también opera rastreadores especializados para diferentes tipos de contenido —Googlebot Image rastrea imágenes, Googlebot Video maneja contenido de video, Googlebot News se dirige a artículos de noticias y AdsBot verifica la calidad de las páginas de destino para Google Ads.
Sé el primero en conocer las nuevas funciones y actualizaciones del producto.
Identificar si un visitante es realmente Googlebot requiere más que verificar una cadena de user-agent, ya que esas cadenas pueden ser falsificadas. Para verificar un rastreador de Google:
Googlebot.googlebot.com o google.com.Google proporciona documentación oficial que lista sus rangos de IP en google.com/bot.html. Cualquier visitante que afirme ser Googlebot y que no supere estos pasos de verificación es un bot falsificado y debe tratarse como sospechoso.
Sí, pero con limitaciones. Los principales motores de búsqueda operan rastreadores dedicados para contenido no textual:
VideoObject para comprender el título, la descripción, la miniatura y la duración.Sin embargo, los rastreadores no pueden “ver” las imágenes como lo haría un humano ni “mirar” un video. Dependen completamente de señales textuales —nombres de archivo, atributos alt, leyendas, texto circundante y datos estructurados— para determinar la relevancia. El contenido bloqueado tras muros de inicio de sesión, muros de pago o incrustado en reproductores JavaScript complejos puede no ser rastreado en absoluto.
Estos términos se usan a menudo indistintamente, pero describen cosas diferentes:
| Aspecto | Rastreador web | Web scraper |
|---|---|---|
| Propósito | Descubrir e indexar URL en toda la web | Extraer datos específicos de páginas seleccionadas |
| Alcance | Amplio — sigue enlaces a todas partes | Estrecho — se dirige a URL o dominios conocidos |
| Salida | Alimenta un índice de búsqueda | Produce datos estructurados (CSV, base de datos, hoja de cálculo) |
| Operador típico | Motores de búsqueda (Google, Bing) | Empresas, investigadores, analistas de datos |
| Respeta robots.txt | Sí (rastreadores legítimos) | Varía — muchos scrapers lo ignoran |
| Ejemplos | Googlebot, Bingbot | Herramientas de monitoreo de precios, scrapers de generación de leads, recolectores de datos para entrenamiento de IA |
Los motores de búsqueda encuentran nuevas páginas a través de varios canales:
La forma más rápida de lograr que una página nueva sea rastreada es enviar su URL directamente a través de Search Console y asegurarse de que esté enlazada desde una página ya indexada en el mismo sitio.
No hay un horario fijo. La frecuencia de revisita depende de:
Los propietarios de sitios pueden influir en la frecuencia de revisita publicando contenido regularmente, manteniendo tiempos de respuesta rápidos del servidor y enviando sitemaps actualizados. Pero en última instancia, el rastreador decide su propio horario basándose en las señales que observa.
Los rastreadores generalmente no pueden acceder a:
Un rastreador solo ve lo que es públicamente accesible y está enlazado. Si una página requiere autenticación o interacción del usuario para renderizarse, es efectivamente invisible para los motores de búsqueda —a menos que el propietario del sitio otorgue acceso explícitamente o proporcione una ruta alternativa, como un sitemap que liste la URL combinado con datos estructurados que describan el contenido.
Construir un rastreador que funcione para unos cientos de páginas es sencillo. Construir uno que funcione para miles de millones es un problema completamente diferente. Los puntos de fallo comunes incluyen:
Para la mayoría de las empresas, ejecutar un rastreador web a gran escala no es práctico sin una infraestructura gestionada. La decisión generalmente se reduce a usar una herramienta existente en lugar de construir desde cero.
En los Estados Unidos, el rastreo web de páginas públicas generalmente es legal. Varias sentencias judiciales —incluyendo *hiQ Labs v.
Sin embargo, la legalidad depende de varios factores:
La distinción entre rastreo para indexación de búsqueda (ampliamente aceptado) y extracción para recolección comercial de datos (más controvertido legalmente) es importante. La mayoría de los rastreadores legítimos de motores de búsqueda operan en un territorio claramente legal.
No —ChatGPT en sí mismo no es un rastreador web. ChatGPT es un modelo de IA conversacional que genera respuestas. Sin embargo, OpenAI opera un rastreador web separado llamado GPTBot, que rastrea páginas web públicas para recopilar datos de entrenamiento para modelos de IA y para admitir funciones de recuperación en vivo en algunos productos de OpenAI.
GPTBot se identifica con el token de user-agent GPTBot y respeta las directivas de robots.txt. Los propietarios de sitios que deseen bloquear GPTBot específicamente pueden agregar lo siguiente a su archivo robots.txt:
User-agent: GPTBot
Disallow: /
Los rastreadores de motores de búsqueda afectan directamente a todos en el ecosistema del marketing de afiliados. Si una página no se rastrea, no se posiciona, y si no se posiciona, no genera tráfico orgánico —y no genera ingresos por afiliación.
El sitio de contenido de un editor vive o muere por su rastreabilidad. Cada reseña de producto, guía comparativa o resumen de ofertas debe ser descubrible por los rastreadores. Los errores comunes de los editores que bloquean el rastreo incluyen:
Los editores deben verificar que sus páginas más valiosas aparezcan en el informe de cobertura del índice de Google Search Console y que ninguna etiqueta noindex ni regla de robots.txt las bloquee involuntariamente.
Un anunciante que gestiona un programa de afiliados necesita que sus páginas de producto sean rastreadas e indexadas para que los editores puedan enlazar a páginas visibles y activas. Si las páginas de producto de un comerciante no están en el índice de Google, los editores no tienen a dónde enviar tráfico. Los riesgos específicos incluyen:
Los comerciantes deben mantener estructuras de URL limpias, enviar sitemaps de productos y monitorear las estadísticas de rastreo en Search Console para detectar problemas antes de que afecten a los socios editores.
Los gestores de programas se sitúan entre comerciantes y editores, y deben entender el comportamiento de los rastreadores para solucionar problemas de visibilidad. Cuando un editor informa que la página de producto de un comerciante “no aparece en Google”, el problema suele ser de rastreo o indexación —no de clasificación. Los pasos prácticos incluyen:
site: de Google.Un gestor de programas que pueda diagnosticar problemas básicos de rastreo agrega valor directo a ambos lados de la relación de afiliados —ayudando a los comerciantes a solucionar problemas técnicos y ayudando a los editores a confirmar que las páginas que promocionan son localizables.
Aprende cómo entender y optimizar para los rastreadores puede mejorar la visibilidad de tu sitio web y su posicionamiento en buscadores.
Aprende cómo funcionan los rastreadores web, desde las URLs semilla hasta la indexación. Comprende el proceso técnico, los tipos de rastreadores, las reglas de ...
Un spider de buscador es un bot automatizado que rastrea páginas web para indexar contenido en buscadores como Google y Bing. Descubre cómo funcionan.
Aprende qué es Google Spider (Googlebot), cómo rastrea e indexa sitios web y por qué es esencial para el SEO. Descubre cómo optimizar tu sitio para un mejor ras...
Únete a nuestra comunidad de clientes satisfechos y brinda excelente soporte al cliente con Post Affiliate Pro.
Consentimiento de Cookies
Usamos cookies para mejorar tu experiencia de navegación y analizar nuestro tráfico. See our privacy policy.