Un spider de buscador es un programa automatizado — también llamado rastreador web, robot spider o simplemente bot — que navega sistemáticamente por la World Wide Web para descubrir, leer y recopilar información de páginas web.
SEO
DigitalMarketing
AffiliateMarketing
WebCrawlers
Spiders
La documentación de rastreadores de Google
explica las categorías de rastreadores y buscadores utilizadas por Google. Usa esa documentación para verificar cómo un rastreador específico de Google accede a un sitio web de afiliados.
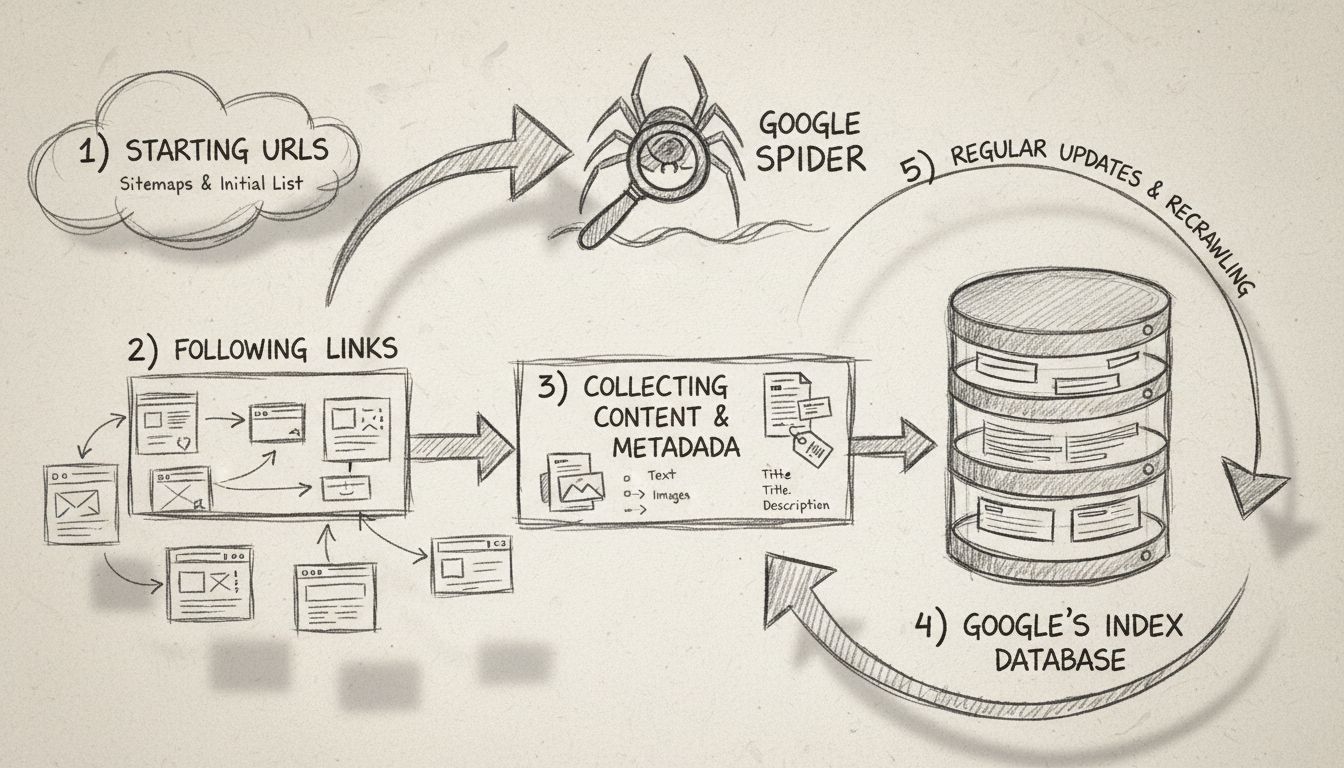
Un spider de buscador es un programa automatizado — también llamado rastreador web, robot spider o simplemente bot — que navega sistemáticamente por la World Wide Web para descubrir, leer y recopilar información de páginas web. Los datos que un spider recopila se envían de vuelta a un buscador, que los organiza en una base de datos masiva llamada índice. Cuando alguien realiza una consulta de búsqueda, el motor extrae resultados relevantes de ese índice, no de la web en vivo.
El término “spider” proviene de la forma en que estos programas navegan por la web: siguen hipervínculos de página en página, similar a cómo una araña se mueve a través de los hilos de su telaraña. El primer rastreador conocido, WebCrawler, se lanzó en 1994 y ayudó a popularizar la metáfora que perduró.
La Definición Principal
Un spider de buscador es un programa automatizado — también llamado rastreador web, robot spider o simplemente bot — que navega sistemáticamente por la World Wide Web para descubrir, leer y recopilar información de páginas web. Los datos que un spider recopila se envían de vuelta a un buscador, que los organiza en una base de datos masiva llamada índice. Cuando alguien realiza una consulta de búsqueda, el motor extrae resultados relevantes de ese índice, no de la web en vivo.
El término “spider” proviene de la forma en que estos programas navegan por la web: siguen hipervínculos de página en página, similar a cómo una araña se mueve a través de los hilos de su telaraña. El primer rastreador conocido, WebCrawler, se lanzó en 1994 y ayudó a popularizar la metáfora que perduró.
Spider, Rastreador o Bot — ¿Cuál es la Diferencia?
Google usa Googlebot, Bing usa Bingbot, y ambos son spiders que realizan la misma función principal.
Lanza tu programa de afiliados hoy
Configura el seguimiento avanzado en minutos. No se requiere tarjeta de crédito.
Comprender el proceso de rastreo ayuda a los propietarios de sitios a tomar mejores decisiones sobre la estructura del sitio, la prioridad de las páginas y el SEO técnico.
URL Semilla y Descubrimiento
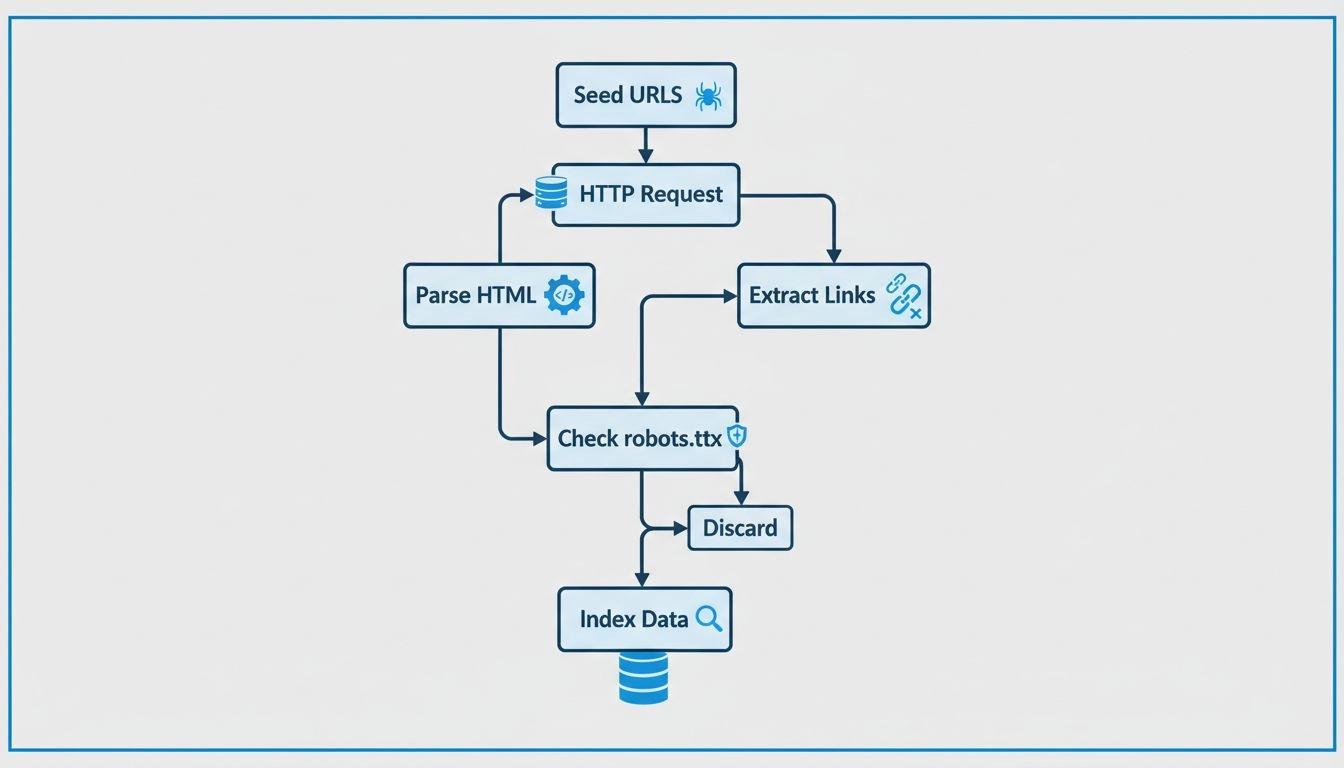
Cada spider comienza con una lista de direcciones web conocidas llamadas URL semilla. Estas pueden provenir de páginas previamente rastreadas, sitemaps XML enviados o enlaces descubiertos durante rastreos anteriores. Desde cada semilla, el spider descarga la página y extrae cada hipervínculo que contiene. Esos enlaces forman una cola — a veces llamada frontera de rastreo — de páginas que visitar a continuación.
Rastreo, Renderizado e Indexación
Cuando un spider llega a una página, hace tres cosas:
Solicita la página — El spider envía una solicitud HTTP, igual que lo haría un navegador. Se identifica con una cadena de encabezado User-Agent (ej., Googlebot/2.1).
Renderiza y lee el contenido — Los spiders modernos, incluido Googlebot, renderizan JavaScript y procesan el Modelo de Objetos del Documento (DOM) completo. Leen texto visible, metaetiquetas, estructura de encabezados, atributos alt de imágenes y marcado de datos estructurados.
Envía datos al índice — El contenido extraído se pasa al proceso de indexación del buscador, donde se analiza, evalúa en cuanto a relevancia y calidad, y se almacena para su recuperación.
El Ciclo de Rastreo en la Práctica
El proceso se ejecuta en un bucle continuo:
Descubrir una URL → Obtener la página → Analizar el contenido y extraer enlaces → Añadir nuevas URL a la cola → Repetir
Un spider también verifica el archivo robots.txt antes de rastrear cualquier página en un dominio. Si el archivo no permite una ruta, un spider con buen comportamiento la omitirá. Los spiders también obedecen las metaetiquetas robots y los encabezados HTTP X-Robots-Tag que les indican que no indexen una página o que no sigan sus enlaces.
¿Cuáles Son los Diferentes Spiders de Buscadores?
Cada buscador importante opera su propio spider. Estos son los que probablemente visitarán tu sitio:
Nombre del Spider
Buscador
Token User-Agent
Googlebot
Google
Googlebot
Bingbot
Bing
Bingbot
Slurp Bot
Yahoo (impulsado por Bing)
Slurp
DuckDuckBot
DuckDuckGo
DuckDuckBot
Baiduspider
Baidu (China)
Baiduspider
Yandex Bot
Yandex (Rusia)
YandexBot
Applebot
Apple (Siri, Spotlight)
Applebot
Googlebot
Googlebot tiene dos variantes: un rastreador de escritorio que simula un navegador de escritorio y un rastreador móvil que simula un smartphone. Desde que Google cambió a la indexación móvil primero, el Googlebot móvil es el rastreador principal para la gran mayoría de los sitios.
Bingbot, DuckDuckBot y Otros
Bingbot impulsa el índice de Bing y también proporciona resultados a Yahoo y otros socios de sindicación. DuckDuckBot rastrea para DuckDuckGo, que complementa su propio índice con resultados de Bing. Baiduspider y Yandex Bot atienden los mercados chino y ruso respectivamente y vale la pena permitirlos si tienes audiencias en esas regiones.
Únete a nuestro boletín
Sé el primero en conocer las nuevas funciones y actualizaciones del producto.
¿Qué Pueden Ver los Spiders de Buscadores?
Contenido y HTML que Procesan
Los spiders de buscador pueden ver todo lo siguiente cuando visitan una página:
Texto visible (encabezados, párrafos, listas)
Estructura HTML y elementos semánticos
Metaetiquetas (título, descripción, robots)
Texto alternativo de imágenes y nombres de archivo
Hipervínculos internos y externos
Datos estructurados (marcado Schema.org)
Etiquetas canónicas y anotaciones hreflang
Códigos de respuesta de página (200, 301, 404, etc.)
Lo que los Spiders No Pueden Ver
Los spiders no “ven” las páginas como lo hace un humano. El contenido incrustado en imágenes sin texto alternativo, el texto renderizado dentro de JavaScript complejo que no se ejecuta correctamente, y el contenido detrás de muros de inicio de sesión o muros de pago es invisible para la mayoría de los spiders. Los elementos interactivos como formularios, menús desplegables y contenido de desplazamiento infinito que requiere clics del usuario también pueden pasar desapercibidos a menos que el sitio utilice técnicas adecuadas de renderizado del lado del servidor o renderizado dinámico.
¿Qué es el Presupuesto de Rastreo y Por Qué es Importante?
El presupuesto de rastreo es la cantidad de páginas que un spider de buscador rastreará en tu sitio en un período de tiempo determinado. Google determina el presupuesto de rastreo basándose en dos factores:
Límite de velocidad de rastreo — qué tan rápido puede Googlebot obtener páginas sin sobrecargar tu servidor.
Demanda de rastreo — cuánto desea Google rastrear tus páginas, impulsado por la popularidad, la actualización y el tamaño de tu sitio.
Para sitios grandes — catálogos de comercio electrónico, editores de noticias o sitios de afiliados con miles de páginas de productos — el presupuesto de rastreo importa. Si los spiders pasan tiempo en URL de bajo valor (parámetros de filtro, IDs de sesión, páginas duplicadas), es posible que no lleguen a tu contenido importante antes de que se cierre la ventana de rastreo.
Cómo Optimizar el Presupuesto de Rastreo
Bloquea URL de bajo valor en robots.txt (páginas de resultados de búsqueda, vistas filtradas, rutas de administración).
Usa etiquetas canónicas para consolidar páginas duplicadas.
Mantén tu sitemap XML limpio y actualizado.
Mejora el tiempo de respuesta del servidor — las páginas más rápidas se rastrean más.
Corrige enlaces rotos y cadenas de redireccionamiento que desperdician recursos de rastreo.
Cómo Controlar los Spiders de Buscadores en tu Sitio
Tienes tres herramientas principales para guiar el comportamiento de los spiders.
Usando robots.txt
Un archivo robots.txt, colocado en la raíz de tu dominio, indica a los spiders qué partes de tu sitio pueden y no pueden visitar. Utiliza una sintaxis simple:
Este ejemplo bloquea a todos los spiders el rastreo de rutas bajo /admin/ y /search/. Puedes dirigirte a spiders específicos usando su token de user-agent:
User-agent: Googlebot
Disallow: /private/
Un archivo robots.txt es una solicitud, no un comando. Los bots maliciosos pueden ignorarlo, pero todos los spiders de buscador legítimos lo respetan.
Metaetiquetas Robots y Encabezados X-Robots
Para el control a nivel de página, usa la metaetiqueta robots en el <head> del HTML:
<metaname="robots"content="noindex, nofollow">
Esto indica a los spiders que no indexen la página y que no sigan sus enlaces. Las mismas directivas pueden enviarse como encabezados HTTP (X-Robots-Tag), lo cual es útil para archivos que no son HTML como PDFs.
Sitemaps XML
Un sitemap XML lista las URL que deseas que los spiders prioricen. Envíalo a través de Google Search Console o Bing Webmaster Tools. Un sitemap no garantiza el rastreo, pero ayuda a los spiders a descubrir páginas nuevas y actualizadas más rápido — especialmente en sitios con arquitectura profunda o enlaces internos limitados.
Rastreadores Web vs. Scrapers Web — ¿Cuál es la Diferencia?
Los términos a menudo se confunden, pero describen propósitos diferentes:
Aspecto
Rastreador Web (Spider)
Scraper Web
Propósito
Descubrir e indexar páginas para búsqueda
Extraer datos específicos de páginas
Operador
Buscadores (Google, Bing)
Individuos, empresas, investigadores
Alcance
Amplio — toda la web accesible
Específico — sitios o puntos de datos concretos
Resultado
Un índice buscable
Datos estructurados (CSV, base de datos, API)
Respeta robots.txt
Sí (los legítimos)
Varía; muchos scrapers lo ignoran
Un spider construye el mapa; un scraper explora el territorio. Ambos son automatizados, pero sirven objetivos fundamentalmente diferentes. Algunas herramientas, como Screaming Frog SEO Spider, difuminan la línea — rastrean como un spider pero se utilizan para auditoría de sitios, no para indexación de búsqueda.
¿Son Peligrosos los Spiders Web?
No inherentemente. Los spiders de buscador legítimos son beneficiosos — sin ellos, tu sitio no aparecería en los resultados de búsqueda. Sin embargo, no todos los bots son amigables.
Bots Buenos vs. Bots Malos
Bots buenos se identifican claramente, respetan robots.txt, rastrean a un ritmo razonable y aportan valor (visibilidad en búsqueda, monitoreo de sitios, archivado).
Bots malos pueden extraer contenido para republicarlo, buscar vulnerabilidades de seguridad, intentar relleno de credenciales o sobrecargar tu servidor con solicitudes excesivas.
Las señales de actividad de bots dañinos incluyen:
Picos en la carga del servidor provenientes de user agents desconocidos
Contenido que aparece en otros sitios sin atribución
Tráfico de rastreo hacia páginas que deberían estar deshabilitadas
Solicitudes repetidas a páginas de inicio de sesión o formularios
Cómo Proteger tu Sitio
Revisa los registros del servidor en busca de cadenas de user-agent sospechosas y rangos de IP.
Usa una CDN o un firewall de aplicaciones web (WAF) con funciones de gestión de bots.
Bloquea bots malos conocidos en robots.txt — aunque los maliciosos lo ignorarán, ayuda con algunos.
Limita la velocidad de los rastreadores agresivos a nivel de servidor o CDN.
¿Es ChatGPT un Rastreador Web?
GPTBot de OpenAI es un rastreador web utilizado para recopilar datos de entrenamiento para modelos de IA. No es un spider de buscador — no impulsa un índice de búsqueda público.
User-agent: GPTBot
Disallow: /
De manera similar, ClaudeBot de Anthropic y Google-Extended (utilizado para el entrenamiento de IA de Google, separado de Googlebot) pueden controlarse mediante el mismo mecanismo. Estos rastreadores no afectan tu posicionamiento en búsquedas — bloquearlos no dañará tu SEO.
¿Qué Buscador No te Rastrea?
Si te preocupa la privacidad, DuckDuckGo y Brave Search son los dos buscadores principales que no rastrean a los usuarios ni crean perfiles personales. Ambos operan sus propios spiders (DuckDuckBot y el rastreador de Brave) y complementan sus índices con resultados de otras fuentes. Se basan en palabras clave contextuales en lugar del historial del usuario para clasificar resultados, lo que significa que el SEO en la página de tu sitio importa aún más para la visibilidad en estas plataformas.
Spiders y Marketing de Afiliados — Por Qué es Importante
Los spiders de buscador afectan directamente a cada rol en el ecosistema del marketing de afiliados.
Para Anunciantes (Marcas con Programas de Afiliados)
Tus páginas de aterrizaje del programa de afiliados, páginas de términos y contenido promocional deben ser rastreables e indexables. Si los spiders no pueden alcanzar la información de tu programa, los afiliados potenciales que busquen “[tu marca] programa de afiliados” podrían no encontrarte orgánicamente. Pasos clave:
Asegúrate de que tu página de registro de afiliados esté en tu sitemap XML y no esté bloqueada por robots.txt.
Usa estructuras de URL limpias — evita IDs de sesión y parámetros innecesarios que creen páginas duplicadas y desperdicien presupuesto de rastreo.
Monitorea Google Search Console para detectar errores de rastreo en tus páginas de conversión clave.
Para Editores (Afiliados)
Cada reseña de producto, artículo de comparación y guía que publiques depende de ser encontrado a través de la búsqueda — y eso significa ser rastreado e indexado. Los spiders son los guardianes. Mejores prácticas:
Los enlaces internos importan: Los spiders siguen enlaces. Un grupo de artículos bien enlazados señala importancia y ayuda a los spiders a descubrir contenido nuevo más rápido.
La actualización provoca re-rastreo: Actualizar contenido existente y cambiar la fecha de lastmod en tu sitemap puede incitar a los spiders a revisitar tus páginas antes.
Evita páginas de afiliados pobres: Las páginas con poco contenido original y muchos enlaces de afiliados pueden ser clasificadas como de bajo valor por los algoritmos de búsqueda. Los spiders aún las rastrean, pero es posible que no se posicionen bien — o no se posicionen en absoluto.
Para Gestores de Programas de Afiliados
Comprender el comportamiento de los spiders te ayuda a apoyar mejor a tus afiliados:
Si el contenido de un afiliado no está posicionándose, el problema puede ser técnico — verifica si sus páginas están indexadas (usa la búsqueda site:) y si están bloqueando spiders involuntariamente.
Al migrar tu plataforma de afiliados o cambiar URL, usa redireccionamientos 301 y actualiza tu sitemap rápidamente. Los spiders seguirán las redirecciones y actualizarán el índice, preservando el valor de los enlaces de tus afiliados.
Las consideraciones de presupuesto de rastreo aplican a sitios de afiliados grandes con miles de páginas de productos. Ayuda a los afiliados a entender qué páginas priorizar en sus sitemaps.
Preguntas frecuentes
Los spiders de buscador navegan sistemáticamente por la web, descargan el contenido de las páginas y siguen enlaces para descubrir nuevas páginas. Envían los datos recopilados a un buscador, que los organiza en un índice utilizado para responder consultas de búsqueda.
Un spider comienza con una lista de URL conocidas (semillas), descarga cada página, extrae su contenido y enlaces, y añade nuevas URL a su cola de rastreo. Verifica las reglas de robots.txt antes de rastrear, renderiza el contenido de la página y pasa los datos al proceso de indexación. Este proceso se repite continuamente.
Los principales tipos son los rastreadores de buscadores (Googlebot, Bingbot), rastreadores de auditoría de sitios (Screaming Frog, Sitebulb), rastreadores de archivo (bot de Internet Archive) y rastreadores de extracción de datos utilizados para monitoreo de precios, investigación o entrenamiento de IA. Solo los rastreadores de buscadores afectan directamente tu posicionamiento en búsquedas.
Publica contenido nuevo regularmente, actualiza páginas existentes, envía un sitemap XML preciso a través de Google Search Console, mejora la velocidad de carga de las páginas y crea enlaces internos hacia contenido nuevo desde páginas ya indexadas. Los sitios con alta autoridad y actualizaciones frecuentes se rastrean con mayor frecuencia.
Los rastreadores web indexan páginas para buscadores; los scrapers web extraen datos específicos para otros fines (inteligencia de precios, generación de leads, investigación). Los rastreadores son amplios y exploratorios; los scrapers son específicos. Los rastreadores legítimos respetan robots.txt; los scrapers a menudo no lo hacen.
Los spiders de buscador legítimos no son dañinos — son esenciales para que tu sitio aparezca en los resultados de búsqueda. Sin embargo, los bots maliciosos que ignoran robots.txt, extraen contenido, buscan vulnerabilidades o sobrecargan servidores pueden ser dañinos. Usa monitoreo de registros del servidor y herramientas de gestión de bots para distinguir y bloquear bots maliciosos.
El presupuesto de rastreo es la cantidad de páginas que un spider de buscador rastreará en tu sitio en un período determinado. Google lo determina equilibrando la velocidad a la que puede rastrear sin dañar tu servidor (límite de velocidad de rastreo) con cuánto desea rastrear tus páginas (demanda de rastreo). La mayoría de los sitios pequeños nunca necesitan preocuparse por esto.
Usa una etiqueta meta robots noindex o un encabezado HTTP X-Robots-Tag en las páginas que quieras mantener fuera del índice. Bloquea el rastreo de directorios sensibles mediante robots.txt. Para sitios completos en desarrollo, usa un entorno de staging protegido con contraseña o sirve un noindex en todo el sitio hasta el lanzamiento.
Envía un sitemap XML a través de Google Search Console y Bing Webmaster Tools. Asegúrate de que las páginas no estén bloqueadas por robots.txt ni etiquetas noindex. Crea enlaces internos hacia páginas nuevas desde contenido ya indexado. Usa la herramienta de Inspección de URL en Search Console para solicitar la indexación de URL individuales.
Impulsa tu marketing de afiliados con información SEO
Descubre cómo entender los spiders web puede ayudarte a optimizar tu sitio para obtener mejores posiciones en los buscadores y mayores ingresos por afiliados.
¿Qué es el Google Spider? Guía completa sobre el rastreo de Googlebot
Aprende qué es Google Spider (Googlebot), cómo rastrea e indexa sitios web y por qué es esencial para el SEO. Descubre cómo optimizar tu sitio para un mejor ras...
¿Cómo funcionan los rastreadores web? Guía técnica completa
Aprende cómo funcionan los rastreadores web, desde las URLs semilla hasta la indexación. Comprende el proceso técnico, los tipos de rastreadores, las reglas de ...
11 min de lectura
¡Estarás en buenas manos!
Únete a nuestra comunidad de clientes satisfechos y brinda excelente soporte al cliente con Post Affiliate Pro.