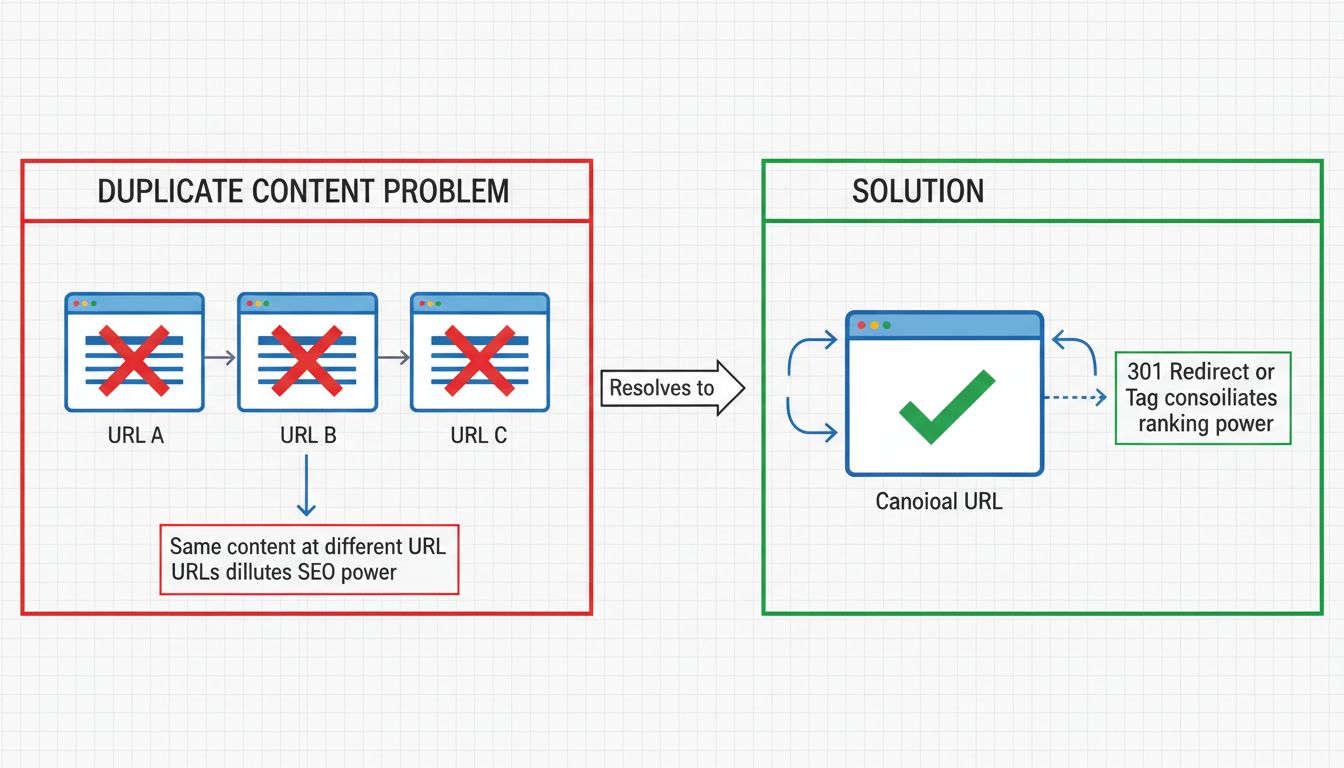
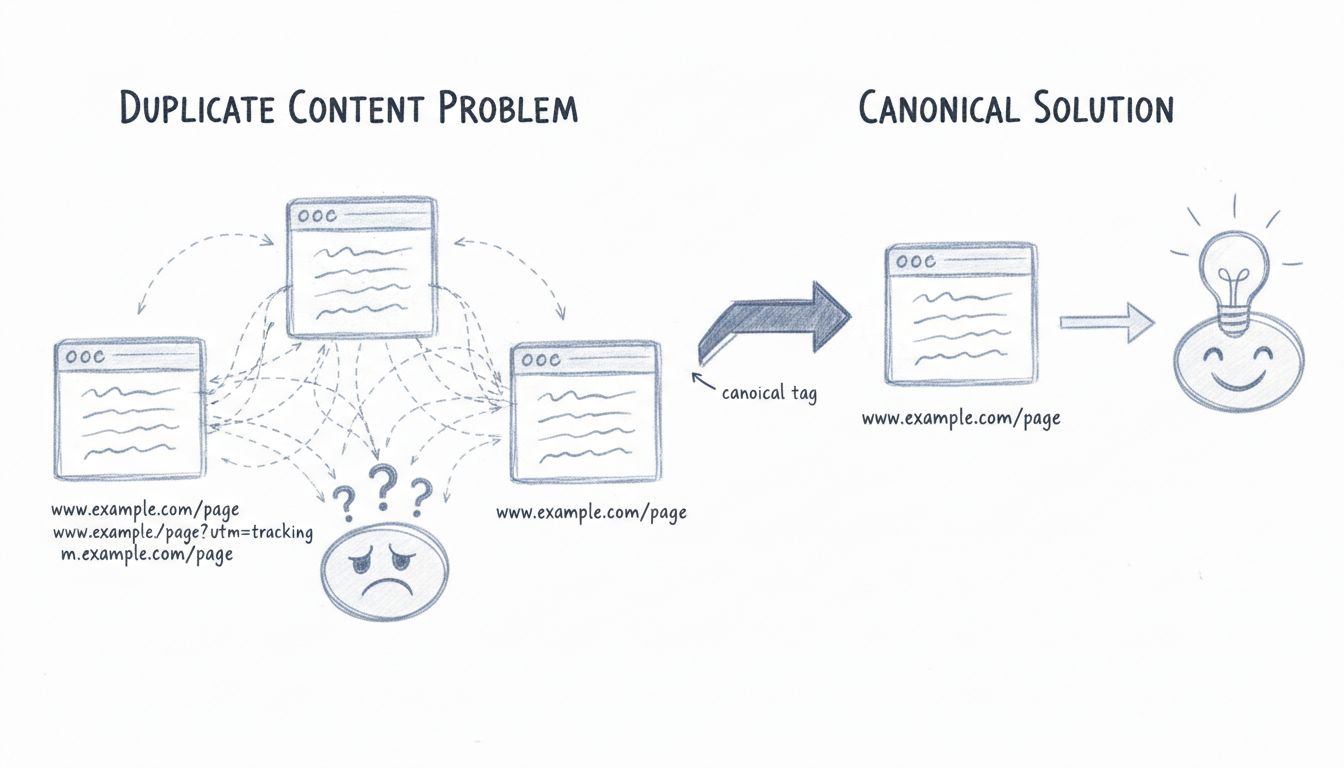
El contenido duplicado son bloques sustanciales de texto, código o medios que aparecen en más de un lugar en internet — lo que significa que dos o más URLs distintas entregan el mismo material o material apreciablemente similar a usuarios y motores de búsqueda. Cuando Google, Bing o cualquier otro rastreador encuentra el mismo contenido en múltiples direcciones web, debe decidir qué versión indexar, cuál posicionar y cuál ignorar. Esa decisión no siempre es la que tú tomarías.
Entender el contenido duplicado es importante para cualquiera que administre un sitio web, gestione un programa de afiliados o publique contenido en línea. Si no se controla, divide las señales de posicionamiento, desperdicia el presupuesto de rastreo y confunde a los motores de búsqueda de los que dependes para obtener tráfico.
¿Qué es el Contenido Duplicado?
El contenido duplicado significa que el mismo contenido o contenido sustancialmente similar reside en más de una URL. Esas URLs pueden pertenecer al mismo dominio (duplicación interna) o abarcar sitios web completamente diferentes (duplicación externa).
Una página califica como duplicada cuando muestra un solapamiento notable en redacción, estructura y mensaje central con otra página, añade poca o ninguna información original y no ofrece un valor significativo más allá de lo que la otra versión ya proporciona. Los encabezados, pies de página y elementos de navegación que se repiten en un sitio no cuentan — los motores de búsqueda entienden que son parte de una plantilla, no del contenido sustancial en sí.
Contenido Duplicado Interno
La duplicación interna ocurre dentro de un mismo dominio. Algunos escenarios comunes incluyen:
- Una página de producto accesible tanto en
example.com/producto como en example.com/producto?color=azul - Versiones HTTP y HTTPS de la misma página que ambas devuelven un código de estado 200
- Variantes WWW y no-WWW ambas accesibles e indexadas
- Versiones para imprimir de artículos que generan URLs separadas
- Filtros de categoría y parámetros de ordenación que crean infinitas combinaciones de URLs en sitios de comercio electrónico
Cada uno de estos crea una dirección separada para el mismo contenido subyacente. Los motores de búsqueda ven múltiples URLs compitiendo por la misma consulta y rara vez recompensan a todas ellas.
Contenido Duplicado Externo
La duplicación externa ocurre cuando el contenido de un dominio aparece en otro. Esto puede ser malicioso — contenido extraído y republicado sin permiso — o completamente legítimo, como en el caso de artículos sindicados distribuidos a sitios asociados. Sin una etiqueta canónica que apunte al original, los motores de búsqueda pueden posicionar la copia por encima de la fuente, o dividir las señales de posicionamiento entre ambas.
Contenido Exacto vs. Casi Duplicado
No todo el contenido duplicado es idéntico. El contenido casi duplicado comparte la misma estructura y mensaje central, pero varía en pequeños detalles: una página de producto donde solo cambia el nombre del color, una página de área de servicio donde solo difiere la ciudad, o una versión traducida del mismo artículo. Google trata estos como duplicados cuando las diferencias son demasiado escasas para justificar una página separada. El umbral no es un porcentaje fijo — se trata de si cada página proporciona un valor genuinamente distinto para quien busca.
Lanza tu programa de afiliados hoy
Configura el seguimiento avanzado en minutos. No se requiere tarjeta de crédito.
¿Por Qué Importa el Contenido Duplicado?
El contenido duplicado crea tres problemas concretos tanto para los motores de búsqueda como para los propietarios de sitios.
Confusión Sobre qué Versión Indexar
Cuando múltiples URLs entregan el mismo contenido, los motores de búsqueda deben elegir una para almacenar en su índice. Pueden elegir la incorrecta — una URL con parámetros no optimizados en lugar de la versión canónica limpia. Las otras versiones pueden ser descartadas por completo, lo que significa que la página que querías posicionar nunca aparece en los resultados de búsqueda.
Equidad de Enlaces Diluida
Los enlaces entrantes se encuentran entre las señales de posicionamiento más fuertes. Cuando sitios externos enlazan a diferentes versiones del mismo contenido — algunos a la versión HTTP, otros a HTTPS, algunos con barra inclinada al final y otros sin ella — la autoridad que esos enlaces transmiten se divide entre múltiples URLs en lugar de concentrarse en una sola. Una página que podría haber estado en la tercera posición podría terminar en la duodécima porque su equidad de enlaces está fragmentada en cuatro URLs duplicadas.
Presupuesto de Rastreo Desperdiciado
Los motores de búsqueda asignan una cantidad finita de tiempo y recursos para rastrear un sitio determinado. Cada URL duplicada que un rastreador procesa es una página única y valiosa menos que puede descubrir e indexar en esa sesión. En sitios grandes — tiendas de comercio electrónico con miles de SKU, centros de contenido de afiliados con páginas generadas dinámicamente — el desperdicio de presupuesto de rastreo por duplicados puede suprimir la visibilidad de páginas genuinamente importantes.
¿Google Castiga el Contenido Duplicado?
No — no en el sentido de una penalización manual. La mayor parte del contenido duplicado en la web es accidental, no engañoso, y los sistemas de Google lo tienen en cuenta.
La distinción es importante. Google sí actúa contra la duplicación deliberadamente manipuladora: sitios que extraen y republican contenido a gran escala únicamente para atraer tráfico de búsqueda, o que generan miles de páginas puerta casi idénticas repletas de palabras clave. En esos casos, Google puede aplicar una acción manual o supresión algorítmica. Pero para el propietario de un sitio web normal con un puñado de URLs duplicadas por parámetros, la consecuencia no es una penalización — es la oportunidad perdida de señales divididas y posicionamiento diluido.
El resultado práctico es similar: tu contenido rinde por debajo de su potencial. Pero entender que esto es un efecto de filtrado algorítmico en lugar de una sanción punitiva te ayuda a priorizar las correcciones correctamente. No estás compitiendo para escapar de una penalización; estás consolidando la fortaleza que ya es tuya.
Únete a nuestro boletín
Sé el primero en conocer las nuevas funciones y actualizaciones del producto.
Causas Comunes del Contenido Duplicado
La mayoría del contenido duplicado se crea accidentalmente, por la forma en que funcionan por defecto los sistemas de gestión de contenidos, las plataformas de comercio electrónico y las arquitecturas de sitios.
Parámetros de URL e IDs de Sesión
Los parámetros de seguimiento (?utm_source=, ?session_id=), las opciones de ordenación (?sort=precio) y las combinaciones de filtros generan URLs únicas para lo que es esencialmente la misma página. Una sola página de producto en un sitio de comercio electrónico puede generar docenas de URLs con parámetros, cada una indexada por separado si no se gestiona.
HTTP vs. HTTPS y WWW vs. No-WWW
Si tu sitio es accesible tanto en http://example.com como en https://example.com, o tanto en https://www.example.com como en https://example.com, tienes al menos dos versiones de cada página. Sin una redirección en todo el sitio de una a la otra, ambas versiones pueden ser rastreadas e indexadas.
Variaciones de Barra Inclinada Final
example.com/pagina y example.com/pagina/ pueden mostrar el mismo contenido pero registrarse como URLs diferentes. La mayoría de las plataformas CMS modernas manejan esto automáticamente, pero servidores mal configurados pueden exponer ambas.
Versiones para Imprimir y Páginas AMP
Las URLs separadas para versiones optimizadas para impresión o AMP de artículos crean duplicados del contenido principal. Si estas versiones alternativas son indexables, compiten con la original.
Cuando otros sitios copian tu contenido — con o sin permiso — crean duplicados externos. Incluso los socios de sindicación legítimos necesitan etiquetas canónicas que apunten a tu original; de lo contrario, su versión republicada puede posicionarse por encima de la tuya.
Descripciones de Productos en Comercio Electrónico y Marketing de Afiliados
Los fabricantes suelen proporcionar la misma descripción de producto a cientos de minoristas y afiliados. Cuando cada vendedor publica ese texto idéntico, los motores de búsqueda ven una duplicación masiva entre dominios.
Navegación Facetada y Páginas de Categoría Filtradas
Los sitios de comercio electrónico y listados que permiten a los usuarios filtrar por tamaño, color, rango de precio o valoración crean explosiones combinatorias de URLs. Una página de categoría con cinco opciones de filtro, cada una con cinco valores, puede generar más de 3.000 URLs únicas — todas mostrando sustancialmente la misma cuadrícula de productos.
Entornos de Prueba y Desarrollo
Los sitios de prueba que accidentalmente quedan indexables duplican todo el sitio de producción. Una configuración incorrecta de robots.txt o una etiqueta noindex faltante en un servidor de desarrollo puede hacer que todo el sitio se refleje en los resultados de búsqueda.
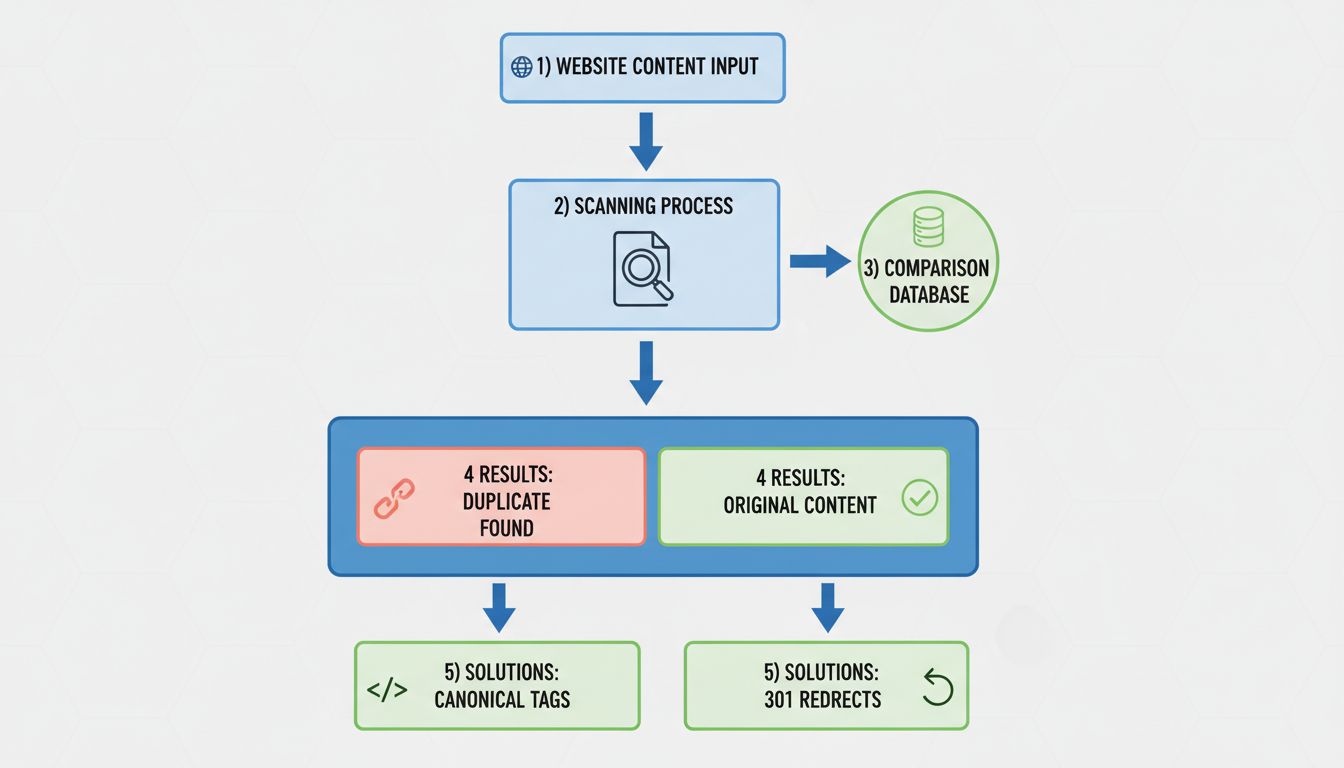
Cómo Encontrar Contenido Duplicado
Antes de poder solucionar el contenido duplicado, necesitas saber dónde está. Varios métodos y herramientas facilitan esta tarea.
Google Search Console
Esta es la forma más rápida y autorizada de detectar duplicaciones que ya están afectando tu posicionamiento.
Herramientas de Auditoría de Sitios
Rastreadores SEO dedicados — Screaming Frog, Sitebulb, Ahrefs Site Audit, Semrush Site Audit — rastrean todo tu sitio y marcan páginas con títulos duplicados, meta descripciones duplicadas y contenido corporal casi idéntico. El informe de “Páginas Duplicadas” de Screaming Frog, por ejemplo, agrupa las URLs por hash de contenido y muestra exactamente qué páginas comparten el mismo contenido o contenido casi idéntico. La mayoría de estas herramientas ofrecen niveles gratuitos suficientes para sitios pequeños y medianos.
Búsquedas de Coincidencia Exacta
Copia una frase distintiva de tu contenido — entre comillas — y pégala en Google. Los resultados muestran cada página indexada que contiene esa frase exacta. Si ves URLs que no esperabas, has encontrado duplicados externos o páginas internas que no sabías que estaban indexadas.
Verificadores de Plagio
Herramientas como Copyscape y Siteliner comparan tu contenido con la web en general y con otras páginas de tu propio dominio. Copyscape es particularmente útil para encontrar sitios que han extraído tu contenido sin permiso. Siteliner escanea los porcentajes de duplicación interna en tu dominio.
Comprobaciones Manuales de Patrones Comunes
Verifica si tu sitio es accesible en múltiples variantes de protocolo y subdominio. Abre http://tusitio.com, https://tusitio.com, http://www.tusitio.com y https://www.tusitio.com. Si más de una resuelve en una página activa en lugar de redirigir, tienes un problema sistémico de contenido duplicado que afecta a cada página.
Cómo Solucionar el Contenido Duplicado
Solucionar el contenido duplicado significa decirle a los motores de búsqueda qué versión de una página es la que quieres posicionar y consolidar todas las señales detrás de ella.
Redirecciones 301
Una redirección 301 envía permanentemente a los usuarios y motores de búsqueda desde una URL duplicada a la versión canónica. Esta es la señal más fuerte que puedes enviar: consolida la equidad de enlaces, elimina el duplicado del índice con el tiempo y garantiza que los visitantes siempre lleguen a la página correcta.
Usa redirecciones 301 cuando:
- Has movido o consolidado páginas de forma permanente
- Necesitas resolver la duplicación HTTP/HTTPS o WWW/no-WWW en todo el sitio
- Un producto o artículo ha sido reemplazado por una versión más reciente
- Estás fusionando varias páginas delgadas en un recurso integral
Etiquetas Canónicas (rel=“canonical”)
<link rel="canonical" href="https://example.com/pagina-original/" />
Las etiquetas canónicas son la herramienta adecuada cuando:
- Necesitas mantener las páginas duplicadas accesibles para los usuarios (por ejemplo, vistas de categoría filtradas, URLs con parámetros)
- Estás sindicando contenido a sitios asociados y quieres que el crédito fluya hacia el original
- Múltiples URLs sirven el mismo contenido por razones legítimas de experiencia de usuario
A diferencia de una redirección, una etiqueta canónica no elimina la URL duplicada de la existencia — solo indica una preferencia. Los motores de búsqueda la tratan como una indicación fuerte, no como una directiva absoluta.
Una etiqueta noindex indica a los motores de búsqueda que no incluyan una página en su índice. Úsala en páginas que tienen un propósito para los usuarios pero que nunca deberían aparecer en los resultados de búsqueda: páginas de agradecimiento, páginas de resultados de búsqueda internos, versiones para imprimir y entornos de prueba.
<meta name="robots" content="noindex" />
Combina noindex con follow si aún deseas que la equidad de enlaces fluya a través de la página hacia otros destinos.
Enlazado Interno Consistente
Cada vez que enlaces a una página de tu propio sitio, usa exactamente el mismo formato de URL. Si tu versión canónica es https://example.com/pagina/, no enlaces a https://www.example.com/pagina o http://example.com/pagina/ en tu navegación, contenido corporal o pie de página. La inconsistencia en tu propio enlazado envía señales contradictorias que socavan tus elecciones canónicas.
Manejo de Parámetros de URL en Google Search Console
La herramienta de Parámetros de URL de Google Search Console (en Herramientas Heredadas) te permite indicar a Google cómo tratar parámetros específicos. Puedes especificar que ?sort= o ?session_id= no cambian el contenido de la página, lo que ayuda a Google a consolidar URLs con parámetros bajo la versión canónica. Úsala con cuidado — una mala configuración puede hacer que Google ignore parámetros que sí producen contenido significativamente diferente.
Creación de Contenido Único
La solución más duradera para el contenido duplicado es crear páginas que sean genuinamente distintas. Para los marketers de afiliados, esto significa escribir reseñas originales de productos, comparativas y guías en lugar de republicar descripciones del fabricante. Para los sitios de comercio electrónico, significa añadir fotografía de producto única, preguntas y respuestas de clientes y guías de compra originales. Los motores de búsqueda recompensan el contenido que añade valor más allá de lo que ya existe en otro lugar.
Contenido Duplicado en el Marketing de Afiliados
Los marketers de afiliados enfrentan un desafío único de contenido duplicado: promocionan productos que cientos o miles de otros afiliados también promocionan, a menudo usando las mismas descripciones, imágenes y especificaciones proporcionadas por el fabricante.
El Problema para los Afiliados
Cuando un afiliado copia una descripción de producto del sitio del comerciante y la publica textualmente, se une a un grupo de páginas idénticas compitiendo por las mismas palabras clave. Google ve docenas o cientos de páginas con el mismo texto y debe elegir una — o ninguna — para posicionar. La página del producto del propio comerciante, con su mayor autoridad de dominio, casi siempre gana. La página del afiliado se hunde.
Esto no es una penalización. Es un problema de relevancia y autoridad: el contenido idéntico no añade nada nuevo a la web, por lo que los motores de búsqueda no tienen razón para mostrar múltiples copias del mismo.
Soluciones Prácticas para Afiliados
Escribe reseñas originales de productos. En lugar de repetir la lista de características del fabricante, describe tu experiencia práctica con el producto. ¿Qué te sorprendió? ¿Qué te resultó frustrante? ¿Cómo se compara con alternativas que has probado? El detalle de primera mano no puede ser duplicado por nadie más.
Añade valor único más allá de la descripción del producto. Incluye fotografía original, tutoriales en video, tablas comparativas creadas por ti mismo, escenarios de uso y respuestas a preguntas que la página del fabricante no aborda.
Usa etiquetas canónicas al sindicar. Si publicas contenido que también aparece en el sitio de tu comerciante o en un blog asociado, añade una etiqueta canónica que apunte a la versión que deseas posicionar. Coordina con el gestor de tu programa de afiliados para acordar qué URL es la canónica.
Evita las estrategias de páginas puerta. Crear docenas de páginas casi idénticas dirigidas a ligeras variaciones de palabras clave — una táctica de afiliados que alguna vez fue común — está explícitamente en contra de las directrices de Google y corre el riesgo de supresión algorítmica. Una página integral que aborde un tema a fondo superará a diez variaciones delgadas.
El Rol del Gestor del Programa
Los gestores de programas de afiliados pueden reducir los problemas de contenido duplicado en su red de afiliados mediante:
- Alentar a los afiliados a escribir reseñas originales en lugar de copiar y pegar el texto proporcionado
- Proporcionar orientación sobre etiquetas canónicas para que los afiliados sepan a qué URL apuntar cuando utilicen contenido compartido
- Monitorear las páginas principales de los afiliados en busca de contenido delgado o duplicado y ofrecer comentarios constructivos
La Perspectiva del Anunciante
Los comerciantes y anunciantes que gestionan programas de afiliados se benefician cuando sus afiliados publican contenido único y de alta calidad. Esto expande la huella de búsqueda de la marca en más palabras clave y consultas de las que el sitio del comerciante podría capturar por sí solo. El contenido duplicado de los afiliados, por el contrario, no añade presencia de búsqueda incremental y puede crear una impresión negativa de la marca cuando los buscadores encuentran el mismo texto en docenas de sitios de baja calidad. Invertir en educación de afiliados y activos creativos únicos genera un dividendo SEO directo.
¿Cuánto Contenido Duplicado es Aceptable?
No existe un umbral de porcentaje oficial por debajo del cual el contenido duplicado sea “seguro”. Google no utiliza una puntuación de duplicación que active una acción a un cierto nivel. En cambio, la cuestión es si cada página proporciona un valor incremental.
El estándar práctico: si no te sentirías seguro explicando a alguien que busca por qué esta página merece existir separadamente de páginas similares en tu sitio o en otro lugar, probablemente es demasiado delgada para justificar su propia URL.